Embargo |
- |
|
||||
배포일자 : 2026.10.12.(월) |
배포번호 : 2026-69호 |
|||||
문의 |
공간미디어연구소 |
미디어시스템연구본부장 |
이태진(042-860-5713) |
E-mail : tjlee@etri.re.kr |
||
미디어시스템연구본부 |
공간미디어플랫폼연구실장 |
추현곤(042-860-1856) |
E-mail: hyungonchoo@etri.re.kr |
|||
대외협력부 |
홍보실장 |
정길호(042-860-0670) |
E-mail : khchong@etri.re.kr |
|||
홍보실 |
행정원 |
임유리(042-860-0738) |
E-mail : yuri@etri.re.kr |
|||
매수 : 보도자료 3매(참고자료 5매, 사진자료 10매. 동영상 2매) |
배포처 : ETRI 홍보실 |
|||||

/
ETRI, 사람아닌‘AI를 위한 차세대 미디어’기술 개발
-"사람 대신 AI가 보는 영상"… ETRI, AI 전용 영상 압축 기술 공개
- 자율주행차·로봇 눈 밝힌다... 대규모 영상 처리의 판을 바꾼다
- 영상은 가볍게, AI 분석은 정확하게… 차세대 AI 미디어 기술 KES 2026서 선봬
국내 연구진이 사람이 아닌 인공지능(AI)의 영상 이해와 분석에 최적화된 차세대 영상 압축 기술을 선보인다. 자율주행차와 로봇, 드론, 지능형 CCTV 등 AI가 영상을 직접 분석하는 시대를 맞아 대규모 영상 데이터를 보다 적은 용량으로 효율적으로 전달할 수 있는 기술이다.
한국전자통신연구원(ETRI)은 오는 13일부터 나흘간 서울 코엑스(COEX)에서 열리는‘KES 2026(한국전자전)’에 참가해‘AI를 위한 영상 부호화 기술’을 비롯한 AI 기반 차세대 미디어 핵심기술 3종을 공개한다고 밝혔다.
ETRI가 개발한 ‘AI를 위한 영상 부호화 기술’은 사람이 영상을 시청하기 위해 개발된 기존 영상 압축 기술과 달리 AI가 영상 속 객체를 검출·분류·추적하는 데 필요한 정보를 효율적으로 추출해 압축·전송하는 차세대 영상 부호화 기술이다.
기존 영상 압축 기술이 사람이 느끼는 화질을 최대한 유지하면서 데이터 용량을 줄이는 데 초점을 맞췄다면, 기계용 비디오코딩(VCM) 기술은 AI의 영상 분석 성능을 유지하면서 AI가 필요로 하는 정보를 보다 효율적으로 전달하는 데 중점을 둔다.
ETRI는 AI 부호화 국제표준인 엠펙(MPEG) VCM을 기반으로 관련 기술을 개발했다. 영상 전체를 기존 방식으로 전송하는 대신 AI 분석에 필요한 특징 정보를 효율적으로 압축·전송함으로써 네트워크 부담을 줄이면서도 AI의 영상 분석 성능을 확보할 수 있다.
향후 자율주행차 간 영상·정보 교환, 지능형 영상보안, 스마트시티, 드론, 산업용 로봇 등 대규모 영상 데이터를 실시간으로 처리해야 하는 분야에 활용될 전망이다. 특히 로봇과 AI가 현실 공간을 인식하고 행동하는 피지컬 AI(Physical AI)가 확산되면서 기계 간 영상정보를 효율적으로 전달하는 핵심기술로 활용 가능성이 커질 것으로 기대된다.
ETRI는 한국전자전(KES) 현장에서 실제 영상을 AI가 분석해 특징 정보를 추출하고, 이를 기반으로 데이터를 효율적으로 압축·전송하는 과정을 시연할 예정이다.
ETRI가 개발해 선뵈는 또다른 기술은 소수 카메라로 실사형 3D 휴먼을 구현하는 기술이다.‘AI 기반 실사 다인 3D 휴먼 생성 및 자유시점 재현 기술’은 소수의 다중 시점 카메라로 촬영한 영상만으로 여러 사람의 3차원 형상을 AI로 복원하고, 사용자가 원하는 시점에서 실감나게 영상을 감상할 수 있도록 하는 기술이다.
기존 자유시점 영상은 다수의 카메라와 복잡한 연산과정이 필요해 제작과 실시간 활용에 제약이 있었다. ETRI는 3D 기하정보 사전학습 인코더와 부화소 기하정보 학습 기술 등을 적용해 적은 수의 카메라를 활용하면서도 고화질 3D 영상을 빠르게 생성할 수 있도록 했다.
특히 순방향 추론 방식을 적용해 장면별 별도의 최적화 과정 없이 고화질 렌더링과 빠른 처리속도를 동시에 구현했다. 이를 통해 스포츠 중계와 공연·전시, 확장현실(XR) 콘텐츠 등 다양한 공간 미디어 분야에 활용할 수 있을 것으로 기대된다.
아울러,‘생성형 AI 기반 사전시각화 영상 제작 지원 기술’도 공개한다. 영화와 드라마, 광고 등 콘텐츠를 본격적으로 제작하기 전에 스케치와 스토리보드, 대본 등을 분석해 제작자가 구상한 장면을 3D 공간으로 미리 구현하는 기술이다.
AI가 스케치·스토리보드·대본 등 다양한 형태의 멀티모달 데이터에서 제작자의 의도를 분석하고 이를 편집 가능한 USD(Universal Scene Description) 기반의 구조화된 3D 장면으로 자동 변환한다.
또한 생성형 AI를 활용해 인물과 사물, 공간 등의 3D 에셋을 자동으로 생성·배치할 수 있다. 제작자는 이를 활용해 영화·OTT·광고 등의 실제 촬영에 앞서 장면 구성과 카메라 위치, 공간 배치 등을 직접 편집하고 검토할 수 있다.
ETRI는 이번 KES 2026을 통해 AI와 미디어 기술의 융합을 기반으로 콘텐츠의 제작·변환·전송·활용에 이르는 미디어 산업 전반의 지능화를 촉진할 계획이다.
아울러 국내 기업과의 기술협력과 사업화 기회를 확대하고 관련 기술의 국제표준화를 추진해 AI 시대 차세대 미디어 기술 경쟁력을 확보할 방침이다.
이태진 ETRI 미디어연구본부장은 “AI가 영상의 주요 소비자로 등장하면서 기존의 사람 중심 영상 압축 기술에도 새로운 변화가 요구되고 있다”며 “AI를 위한 영상 부호화 기술을 통해 대규모 영상 데이터를 보다 효율적으로 전달하고 분석할 수 있는 기반을 마련할 것”이라고 말했다.
이어 이 본부장은 “영상 부호화뿐만 아니라 3D 휴먼, 생성형 AI 기반 콘텐츠 제작 기술 등 AI와 미디어의 융합 연구를 지속해 자율주행, 로봇, 스마트시티, 산업 자동화와 차세대 미디어 등 다양한 분야의 경쟁력 강화에 기여하겠다”고 밝혔다.
한편, 관련 기술은 과학기술정보통신부와 정보통신기획평가원의 지원을 받아 수행 중인 △“(전문연구실) 기계를 위한 영상부호화 기술” △ “(전문연구실) 이머시브 미디어 전문연구실”과제 및 방송미디어통신위원회와 정보통신기획평가원의 지원을 받아 수행중인 △“생성형AI 기반 미디어 제작보조 사전시각화 기술 개발” 과제를 통해 개발되었다. <보도자료 본문끝>
용어설명 |
1) MPEG VCM(Video Coding for Machines) :사람이 아닌 인공지능(AI)과 머신러닝 시스템(기계)이 영상을 효율적으로 인식하고 분석할 수 있도록 최적화된 차세대 비디오 압축 표준 기술
2) 기계용 비디오코딩(VCM, Video Coding for Machines) 기술 :사람이 보는 영상이 아니라 인공지능(AI)과 같은 기계가 분석하고 처리하기에 가장 효율적이도록 최적화하여 영상을 압축·부호화하는 표준 기술 및 패러다임
3) 순방향 추론(Feed-forward inference) : 장면마다 별도의 최적화 과정 없이, 입력 영상을 신경망에 순방향으로 전달하여 3차원 표현을 직접 예측하는 방식. 장면별 최적화가 필요한 기존 방식보다 빠른 처리가 가능함.
4) USD(Universal Scene Description) : 3D 장면의 구성요소(모델·재질·조명·카메라 등)와 동작 정보를 표준화해 저장·공유하는 3D 장면 기술 규격. 다양한 제작 도구 간 3D 데이터를 호환·연동하기 위한 파일/데이터 표준.
5) 3D 에셋(Three-Dimensional Asset) : 3차원 콘텐츠 제작에 사용하는 디지털 자산의 총칭. 3D 모델, 텍스쳐(재질), 리깅, 애니메이션 등의 데이터 묶음.
참고1 |
기계를 위한 영상 부호화 기술 |
< 시스템 구조도>
사람이 영상을 관람하기 위해 개발된 기존의 비디오 부호화 기술과 달리, 로봇이나 드론 등 AI가 영상을 이해하는 최적화된 특징을 추출 및 압축하여 전송하는 새로운 개념의 부호화 기술 ◦MPEG VCM 기반 AI 영상 부호화 기술 (VVC 대비 4배 이상) ◦Edge Computing 적용이 가능한 실시간 저복잡도 VCM 인-디코더 기술 ◦전송 및 응용 환경에 따라 최적화된 VCM 툴 적용 기술 |
<시연 구성 및 시연 화면>
참고2 |
AI 기반 실사 다인 3D 휴먼 생성 및 자유시점 재현기술 |

< 시스템 구조도>
소수의 다중 시점 카메라 영상에서 AI 기반 순방향 신경망으로 실사 다인 객체의 3차원 표현을 생성하고, 사용자가 원하는 시점의 다인 객체 영상을 고속으로 생성·재현하는 기술 ◦순방향 신경망 기반 3차원 객체 가우시안 표현 예측 기술 ◦3D 기하 정보 사전 학습 인코더 기술 ◦관절 구조 기반 부화소 단위 세부 객체 기하정보 학습 기술 ◦트랜스포머 기반 인코더와 다계층 신경망 디코더의 TensorRT 기반 추론 가속화 기술 |
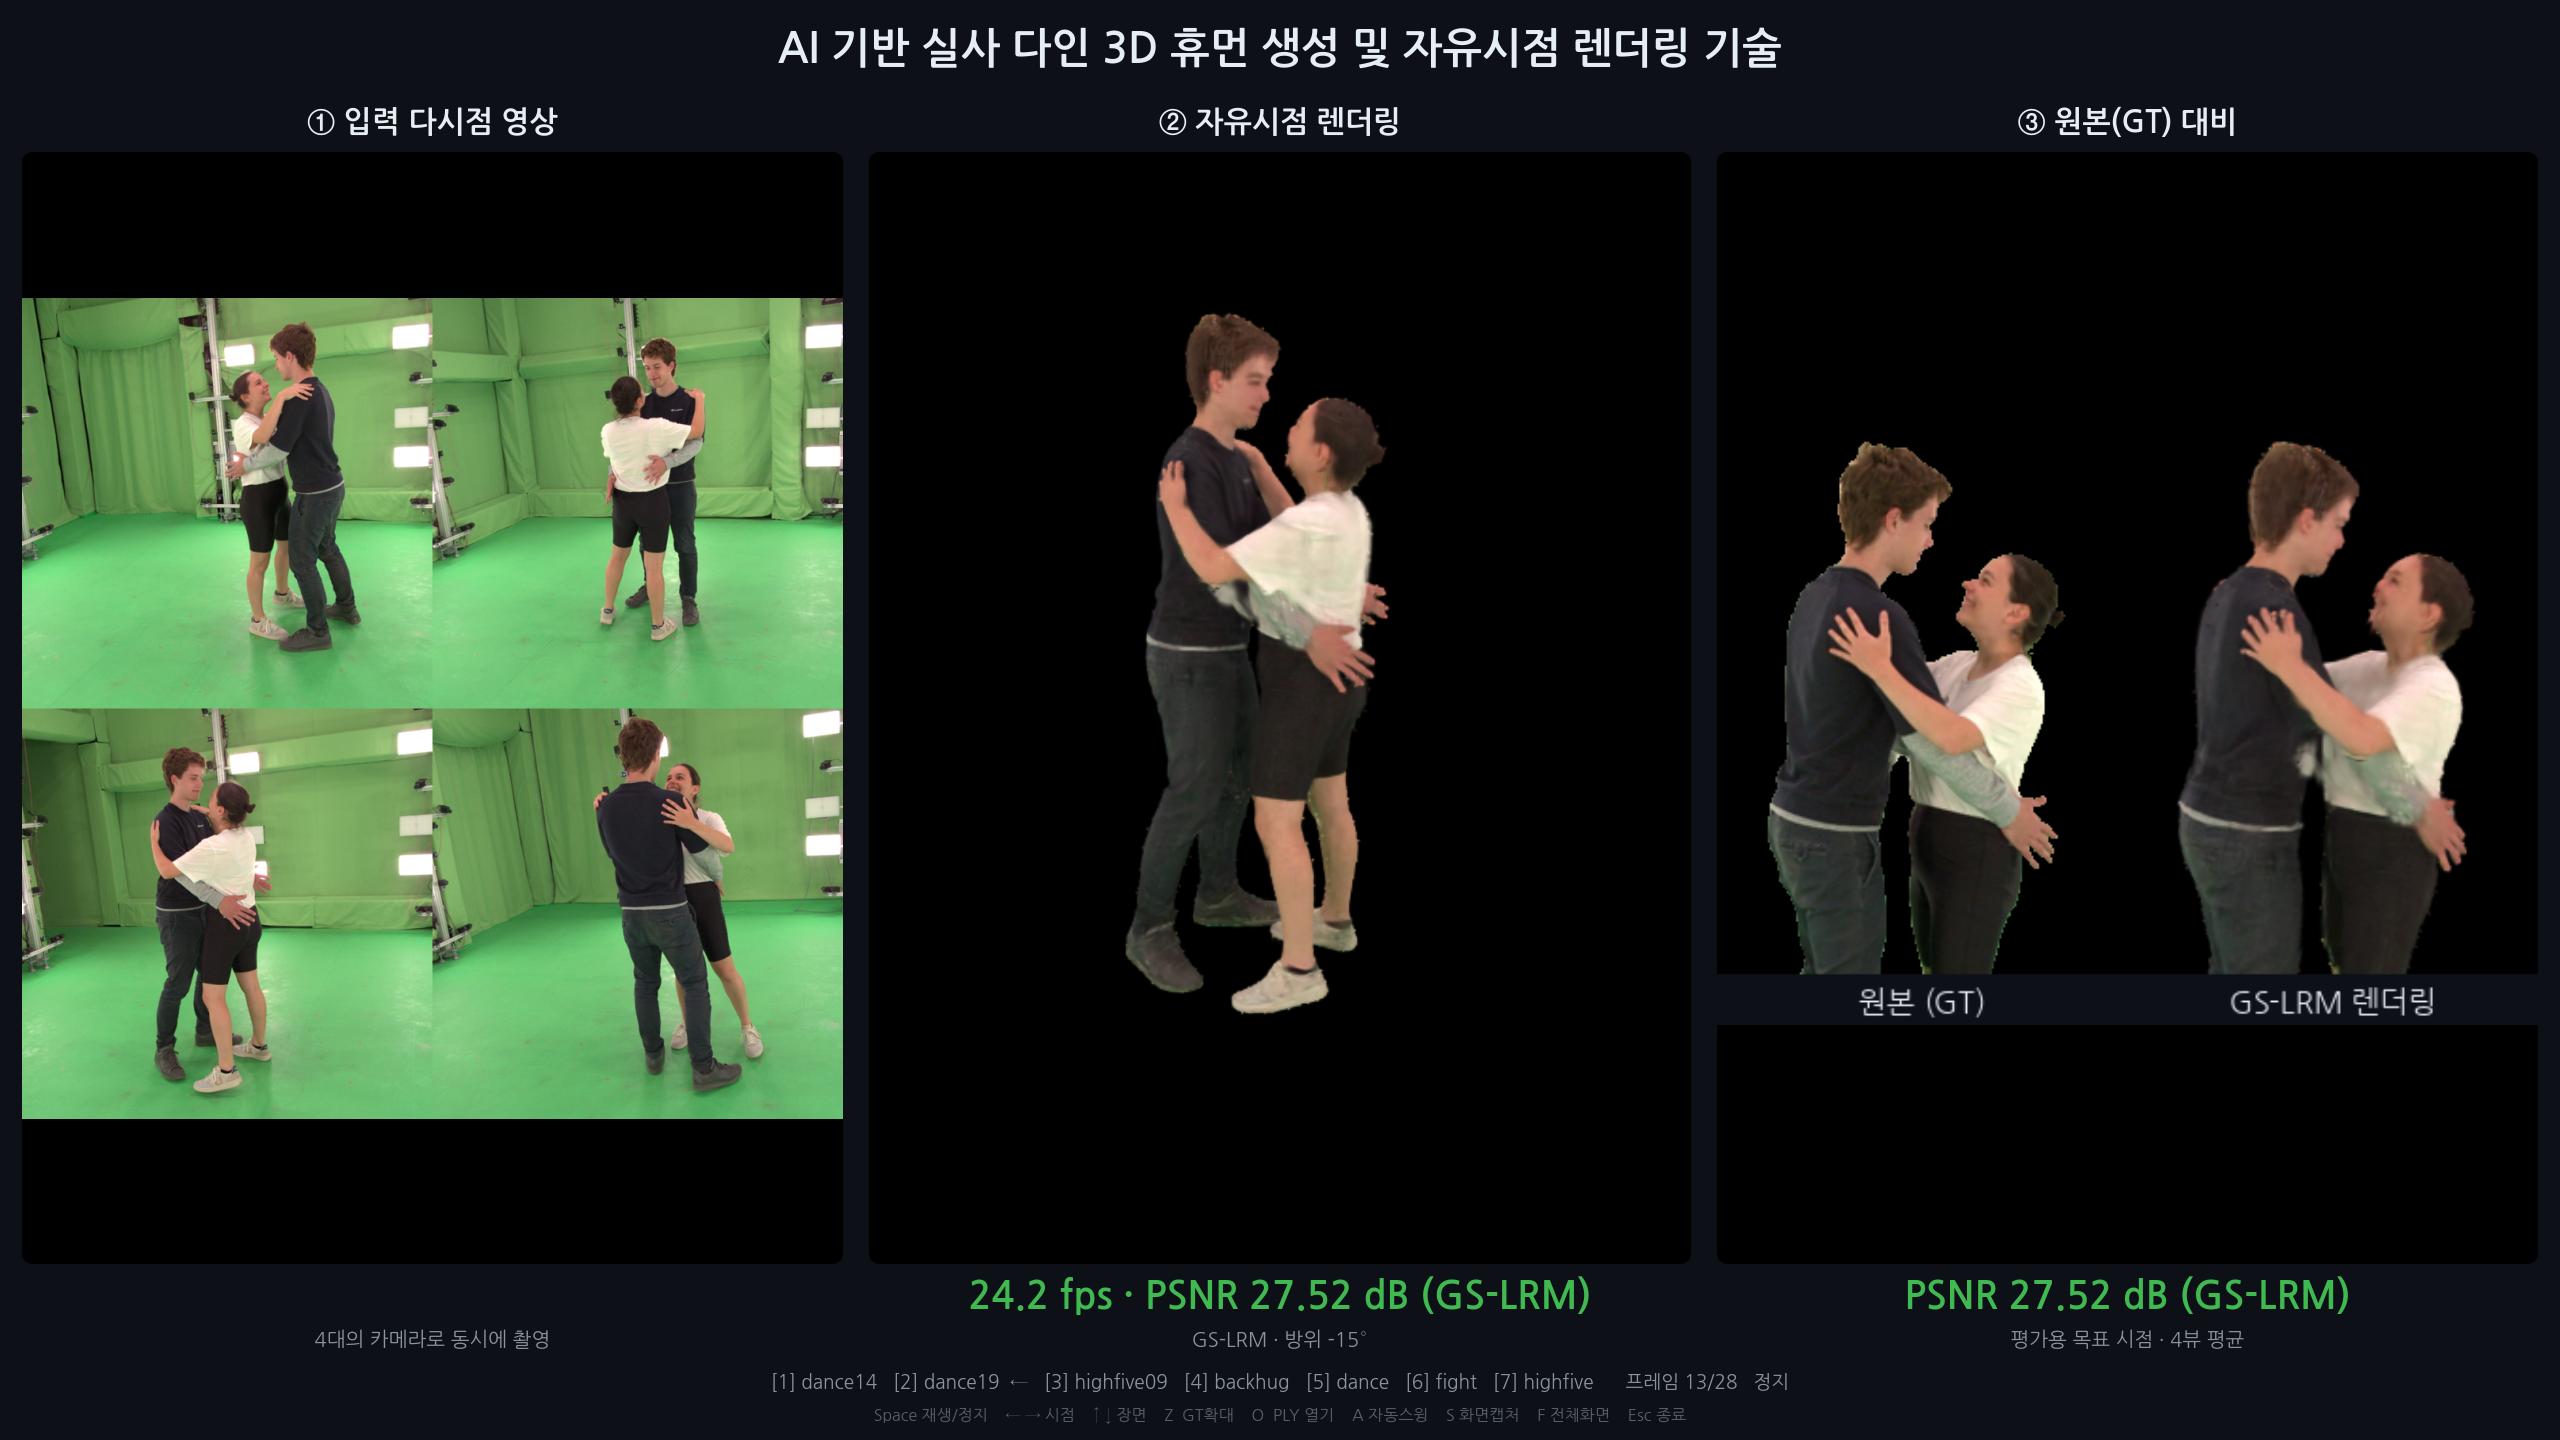
<시연 구성 및 시연 화면>
참고3 |
생성형 AI 기반 사전시각화 영상 제작 지원 기술 |

< 시스템 구조도>
사용자가 콘텐츠의 스케치, 대본 등의 정보를 입력하면 AI가 사용자의 의도를 분석하여 사전시각화 관련 3D 에셋을 자동 생성하고 시각화하는 기술 ◦멀티모달 사용자 의도 자동 분석 기술 ◦생성형 AI 기반 3D 에셋(인물, 사물, 공간) 자동 생성 기술 ◦3D 에셋 활용 USD 자동 구성 기술 |


<시연 구성 및 시연 화면>

